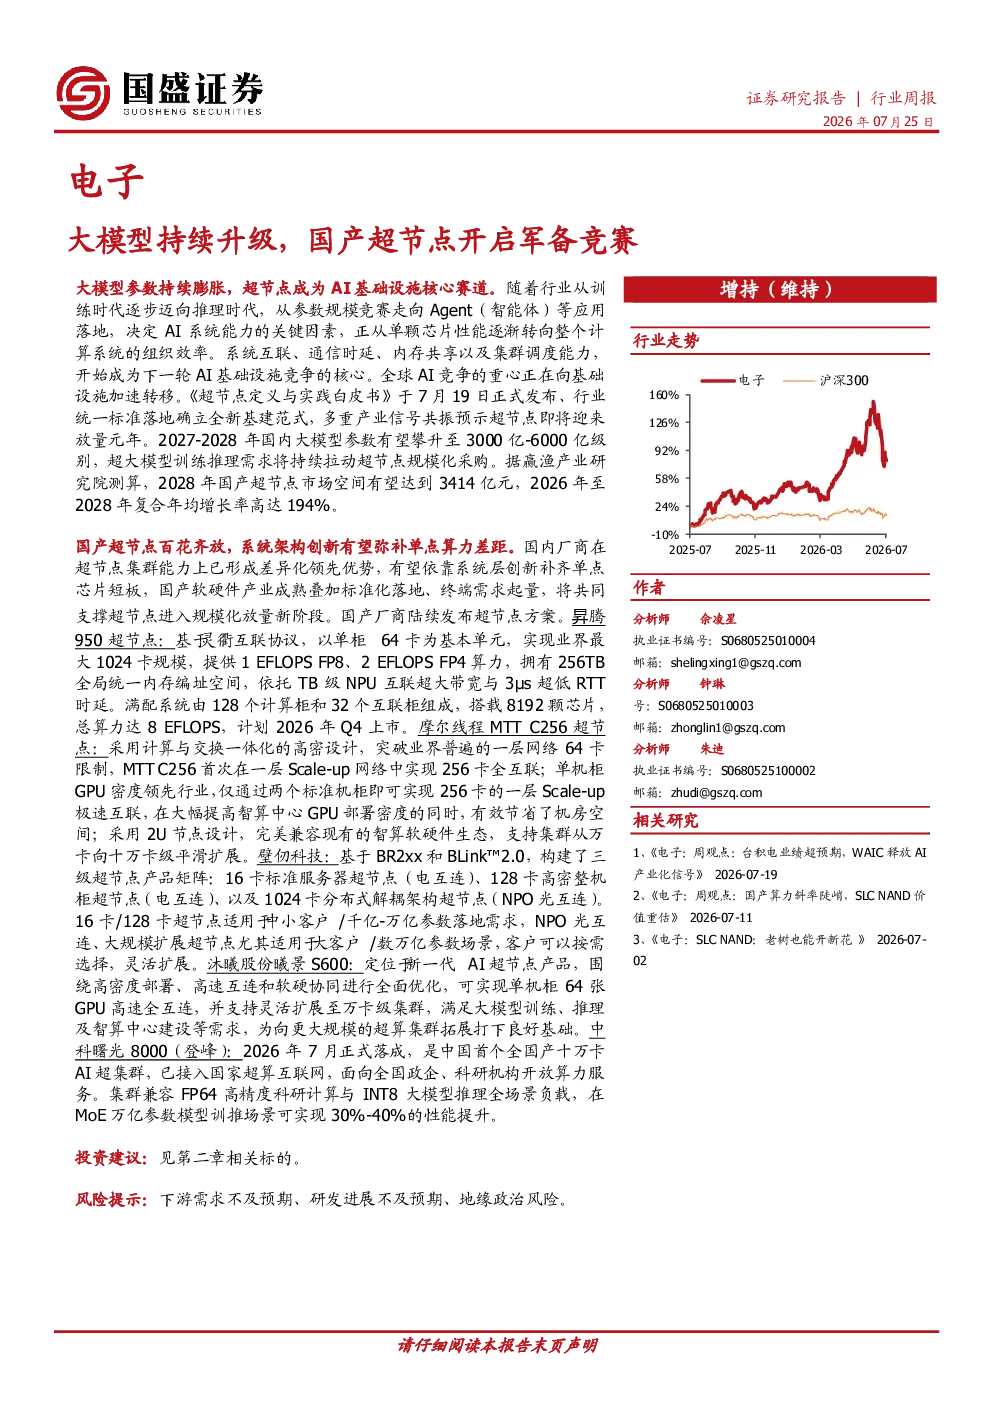
大模型持续升级,国产超节点开启军备竞赛
1.1 大模型参数持续膨胀,超节点成为AI基础设施核心赛道
- 国产芯片推动大模型发展,WAIC 26展示超过300款大模型产品,月之暗面Kimi K3参数达2.8万亿,预示未来5万亿至6万亿参数模型的出现。
- 大模型参数膨胀导致算力需求激增,Kimi K3上线后逼近现有集群承载极限,推动单模型所需卡量和集群规模成倍增长。
- 万卡集群需超节点支持,超节点市场规模预计2028年达3414亿元,2026年至2028年复合年均增长率高达194%。
- 行业从训练时代迈向推理时代,AI系统能力关键因素从单芯片性能转向计算系统组织效率,系统互联、通信时延、内存共享和集群调度能力成为核心竞争要素。
- 《超超节点定义与实践白皮书》发布,确立超节点AI基础设施建设新范式,超节点具备跨物理节点统一内存编址能力,逻辑上如同单台计算机。
- 标准化落地推动超节点放量,预计2027年中国大模型参数规模将突破3000亿,2028年达5000亿至6000亿,超节点对超大模型推理性价比价值凸显。
1.2 国产超节点百花齐放,系统架构创新有望弥补单点算力差距
- 国产超节点以集群和架构优势弥补单芯片性能差距,华为昇腾950超节点已实现1024卡规模,领先海外同行。
- 系统级能力竞争加剧,多家国内厂商展出超节点产品,产业协同特征突出,如中兴通讯联合多家厂商打造国产高性能Matrix超节点。
- 华为昇腾超节点方案:
- 昇腾384超节点:国内唯一规模商用超节点,累计落地750多套,覆盖20多个行业。
- 昇腾950超节点:首次真机亮相,1024卡规模,提供1 EFLOPS FP8、2 EFLOPS FP4算力,拥有256TB全局统一内存编址空间,计划2026年Q4上市。
- Atlas 850E风冷超节点:针对传统风冷机房设计,单超节点可扩展至96卡,覆盖全量低精度格式,可稳定实现10毫秒级时延推理。
- 互联协议:华为灵衢协议,已开放共建开放生态。
- 中科曙光超节点方案:
- 曙光8000(登峰):中国首个全国产十万卡AI超集群,兼容FP64高精度科研计算和INT8大模型推理,MoE万亿参数模型训推性能提升30%-40%。
- 超节点scaleX40:全球首个无线缆箱式超节点,单节点集成40张GPU,总算力超过28PFLOPS(FP8精度)。
- 超节点scaleX640:单机柜可集成640张国产加速卡,依托scaleFabric无损高速网络完成十万卡统一组网调度。
- 摩尔线程MTT C256超节点:
- 极致互联:突破一层网络64卡限制,实现256卡全互联,卡间通信延迟压缩至亚微秒级。
- 高密度部署:单机柜GPU密度领先行业,仅需两个标准机柜即可实现256卡一层Scale-up极速互联。
- 生态兼容:采用2U节点设计,完美兼容现有智算软硬件生态,支持集群从万卡向十万卡级平滑扩展。
- 壁仞科技超节点方案:
- 芯片:首创Chiplet(芯)架构大算力芯片,BR2xx系列GPU支持FP8/FP4低精度高算力计算,原生集成超节点互连能力。
- 协议:自研BLink™2.0超节点互连协议,核心能力包括内存语与互连、在网计算、智能拥塞控制和多层链路自愈。
- 产品矩阵:构建三级超节点产品矩阵,16卡/128卡适用于中小客户/千亿-万亿参数落地需求,1024卡分布式解耦架构超节点适用于大客户/数万亿参数场景。
- 应用方案:Token工厂解决方案,践现95%以上缓存命中率,大幅降低重复计算开销;联合中国电信首创跨厂商异构混推方案,有效吞吐提升20%。
- 沐曦股份曦景S600超节点:
- 定位新一代AI超节点产品,单机柜64张GPU高速全互连,支持灵活扩展至万卡级集群。
- 采用OEX架构设计,通过正交连接器实现两级交换拓扑,践现GPU之间低时延、高带宽通信。
- 采用“三0设计”方案,践现计算节点0线缆、交换节点0线缆以及计算节点与交换节点之间0线缆,大幅减少布线损耗和故障风险。
- 解耦模块化设计,关键模块支持快速部署和维护,电源和液冷管路支持盲插热插拔,显著降低数据中心运维成本。