DeepSeek逆袭核心观点与影响
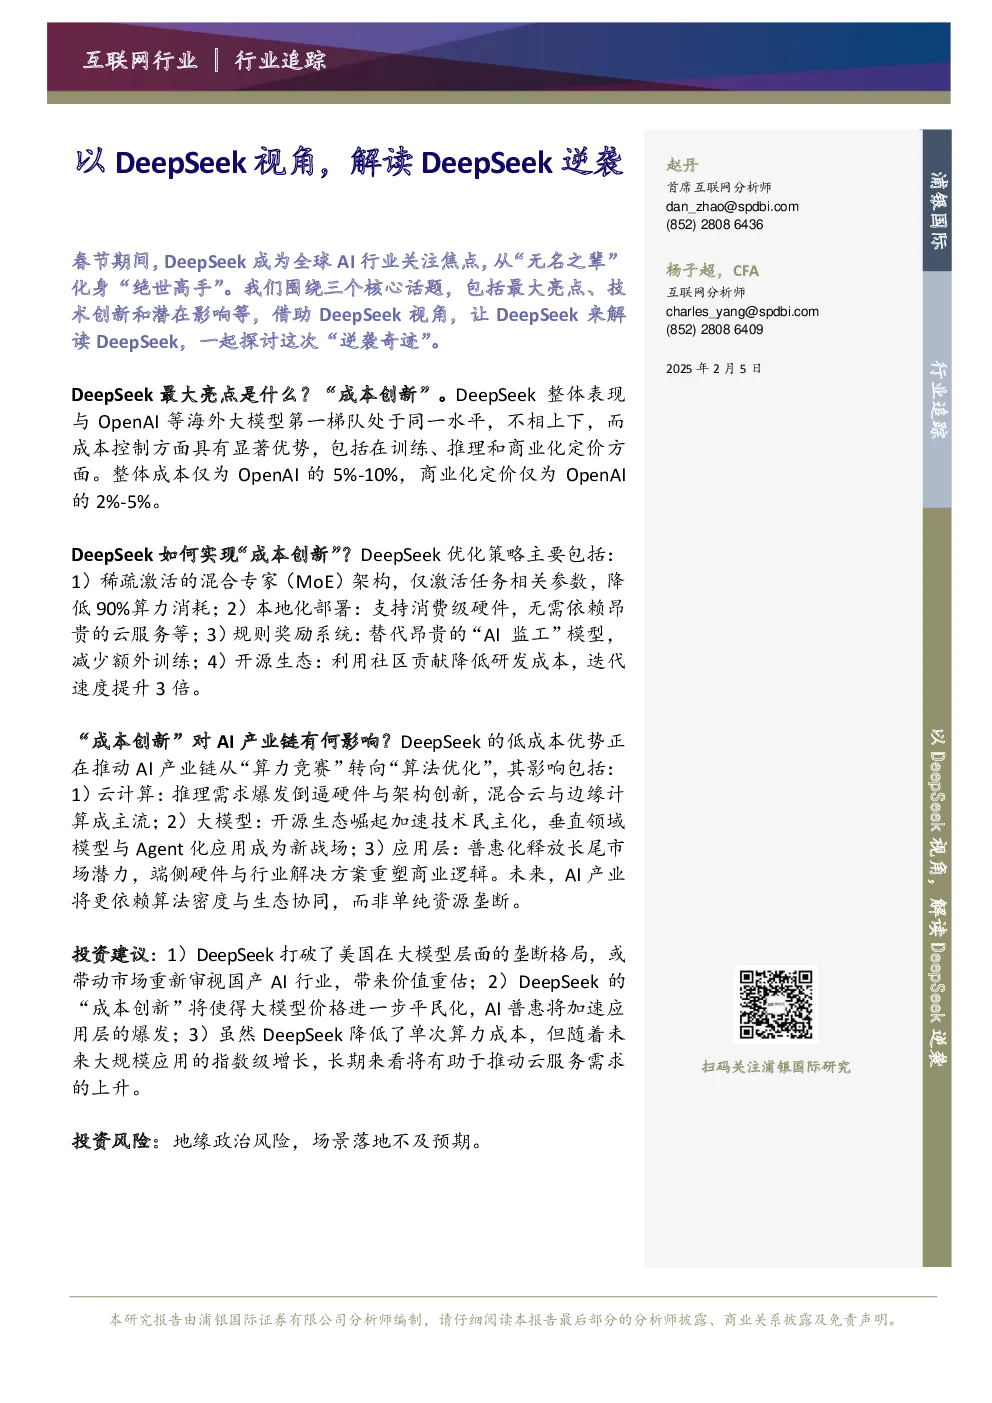
最大亮点:成本创新
- DeepSeek在整体表现上与OpenAI等海外大模型第一梯队相当,但在成本控制方面具有显著优势。
- 训练成本:DeepSeek-V3训练成本仅为558万美元,为OpenAI的5%-10%。
- 推理成本:DeepSeek输入费用0.14美元/百万tokens(缓存未命中),输出费用0.28美元/百万tokens,远低于OpenAI。
- 商业化定价:DeepSeek每百万tokens价格0.48美元,仅为OpenAI的2%-5%。
成本创新实现策略
- 稀疏激活的MoE架构:仅激活任务相关参数,降低90%算力消耗。
- 本地化部署:支持消费级硬件(如RTX 4090),无需依赖昂贵的云服务。
- 规则奖励系统:替代昂贵的“AI监工”模型,减少额外训练开销。
- 开源生态:利用社区贡献降低研发成本,迭代速度提升3倍。
技术异同对比
- 相同点:均基于Transformer架构,强调推理能力,采用多阶段训练。
- 不同点:
- 训练方式:DeepSeek依赖强化学习(GRPO算法),OpenAI依赖监督微调(SFT)。
- 架构设计:DeepSeek采用MoE架构,OpenAI优化Transformer层结构和注意力机制。
- 推理与生成能力:DeepSeek在数学、代码生成领域表现优异,OpenAI在NLP和文本生成方面更突出。
- 成本与效率:DeepSeek成本更低,OpenAI依赖大规模资源。
- 应用场景:DeepSeek适合垂直领域,OpenAI适合通用任务。
对AI产业链的影响
- 云计算:
- 推理需求爆发(2026年推理算力占比超70%),硬件厂商转型至专用AI芯片。
- 边缘计算与混合云崛起,云服务商需优化推理集群架构。
- 大模型:
- 开源生态推动技术民主化,R1模型开源6天下载量达110万次。
- 垂直领域模型爆发,如金融、医疗领域应用。
- 应用层:
- 中小开发者与长尾市场激活,DeepSeekAPI定价低廉。
- 商业模式创新,传统云厂商转向“AI+行业解决方案”。
研究结论
- DeepSeek推动AI产业链从“算力竞赛”转向“算法优化”。
- 未来AI产业更依赖算法密度与生态协同,而非资源垄断。
- 中国企业需抓住开源化、设备端化趋势,但需警惕技术跃进风险。
投资建议
- DeepSeek打破美国垄断格局,或带动国产AI行业价值重估。
- “成本创新”加速AI普惠,推动应用层爆发。
- 长期来看,DeepSeek将推动云服务需求上升。
投资风险